深色模式
EP5 好回覆的公式:品質由什麼決定?
為什麼人家曬出來的 AI 回覆又長又貼角色,你的感覺就差很多?不是運氣,是有一套公式。而且這套公式裡,你自己的影響力比你想的大很多。這頁要把這條公式拆開,讓你知道每一個變因分別卡在哪、哪一項其實掌握在你手上。
EP 5
好回覆的公式
提詞×設定×上下文×算力×你的輸入
低投入
隨便。
高投入
(推開木門,雨水順著髮梢滴下)
「抱歉,來晚了。」(聲音有點緊張)
✓ 動作描寫✓ 場景細節✓ 情緒變化
低投入
給得少,演得也保守
高投入
給得多,演得更到位
豪華店面
廚房裡
你看不到
平台真的便宜嗎?
上下文
桶子變小
模型
學徒掌勺
輸出
回覆截短
速度
尖峰降速
體驗到的「笨」,常是省錢決策
一句話記住
你提供什麼料,
大廚就準備什麼菜。
大廚就準備什麼菜。
你那則訊息在桶底,影響力最大。
你怎麼寫,AI 就跟著怎麼寫
好回覆的公式
這是整個課程對 AI RP 玩家最實用的一個框架。一則回覆好不好,可以拆成四個變因相乘:
好回覆 = 好的提詞 × 好的設定 × 足夠的上下文 × 模型算力 注意是乘法,不是加法
注意這是乘法不是加法。任何一項是零,整體結果就是零。
一個寫得很好的角色卡,配上一個桶子上下文只有 10K token 的平台,出來的效果照樣會很差;反過來,再強的模型如果角色卡寫得一塌糊塗,也救不回來。任何一個變因接近零,最後出來的結果就接近零。但反過來說也是好消息:每一個變因都提升一點,效果是倍增的。
來玩一下:好回覆的公式
拖動四個滑桿(0~10),看「好回覆指數」怎麼變。先試試:把任何一個拉到 0。
好回覆指數
18 / 100
如果是加法
65
6 × 7 × 6 × 7 ÷ 100 = 18
每一項都提升一點,效果是倍增的:每項再 +1,會從 18 變成 31(約 1.7 倍)。
照課文的兩個例子擺擺看
加法會騙人:一項爛掉,其他項還能把分數撐著。乘法不會——任何一項是零,整體就是零。
四個變因分別是什麼?
把整套流程想成一間廚房,四個變因正好對應廚房裡的四件事:提詞是菜單、設定是火候、上下文是桶子大小、算力是大廚等級與做菜時間。下面逐項展開。
提詞(Prompts)— 菜單
這包含你的系統提詞、角色卡(character card)品質,以及預設(preset),也就是加在對話裡的各種引導指令。
角色卡寫得好,角色的個性、說話方式、情感反應就越精確;角色卡寫得模糊,AI 就只能按照「一般人物」的平均值在猜。菜單寫得越清楚,廚房上菜越準確。
設定(Settings)— 火候
這是酒館裡的各種參數:Temperature(溫度,控制回覆的隨機性和創意度)、上下文長度、輸出長度等等。火候不對,同樣的食材也會做出不同的味道。
初學者先用預設值就夠,不需要急著調這些。
上下文(Context)— 桶子大小
就是桶子裡的全部內容(參考 EP3 記憶之桶)。桶子越大,大廚能參考的資料越多,回覆品質往往越穩定。
桶子太小的直接後果是:對話幾十回合之後,角色卡和世界書的設定被大量聊天紀錄稀釋,感覺角色越聊越走樣。
模型算力 — 大廚等級與做菜時間
在玩 LLM 的時候,你可以自己選擇喜歡的廚師(AI 模型),但這位大廚被分到多少火力、後台給多少資源,是 AI 公司決定的,使用者無法控制。
大模型(像 Gemini Pro、Claude Opus)的表現就會比平價版(Gemini Flash、Claude Sonnet)模型聰明。
「一個 AI 模型剛出來超強,用一陣子就慢慢變笨」這種感覺也是真的,不是你的錯覺。這些都是 AI 公司為了省錢偷偷做的事,你全都管不到:
- 被迫偷懶:還是同一個大廚,但公司可以讓他「少用點心」——用更省的方式去跑(量化),或給會思考的模型更少的思考時間。菜還是他做的,但他沒辦法認真做菜。
- 偷改食譜:模型名字沒變,但背後的版本被官方默默更新過——有人實測過,同一個名字的模型,幾個月內表現就差很多。
最被低估的變因:你自己的輸入
這是公式裡最少被討論的一項,也是影響力最大的一項。
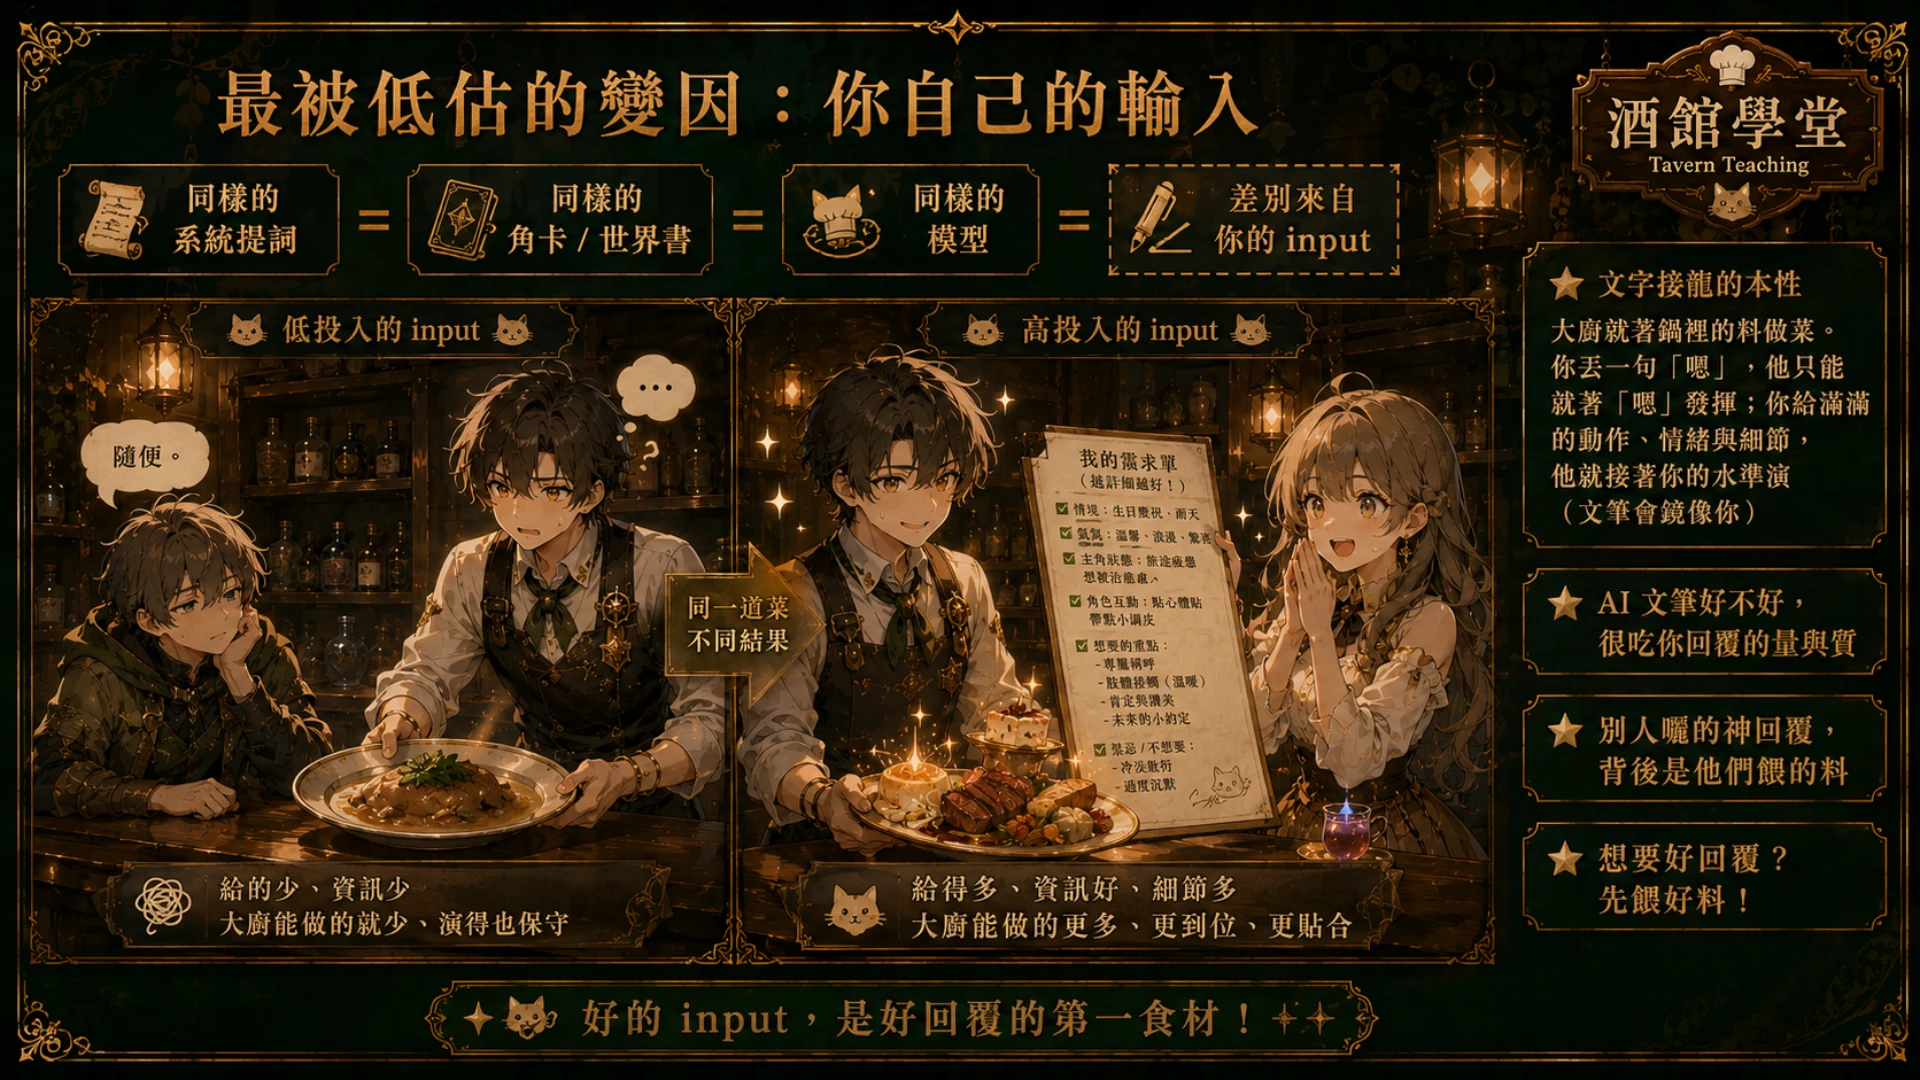
同樣的系統提詞、同樣的角色卡、同樣的模型 — 為什麼你的角色跟別人演得不一樣?答案是:最大的變因往往是你自己的輸入。
AI 的文字接龍特性決定了:大廚是就著鍋裡現有的料做菜的。
你丟一句「嗯」,大廚就只能就著一個「嗯」來發揮;你寫了滿滿的動作描寫、情緒變化、場景細節,大廚就會接著你的水準來演。模型的文筆會「鏡像」你的文筆 — 你丟什麼,他就接什麼。
回想前面提到的 U 形注意力分佈:你最新的那則訊息正好在桶底(影響力最大的位置)。AI 回覆寫得好不好,很大程度取決於你那則訊息的內容量和品質。
所以不用覺得「我的角色不貼合」或「為什麼跟別人家的不一樣」。別人在社群上曬出來的神回覆,那不是運氣,背後可能是他們輸入的對話品質高。
鐵律:你提供什麼料,大廚就準備什麼菜。你那則訊息在桶底、影響力最大,你的輸入品質直接決定下一則回覆的品質。
這也意味著一件好事:就算你現在用的模型不是最強的,光是提升自己的輸入品質,就能顯著改善回覆。
你玩的平台真的便宜嗎?
現在來談談這些看起來「很便宜」的平台。說穿了,天下沒有白吃的午餐——所謂免費或低價,只是把成本藏在你看不到的地方而已。
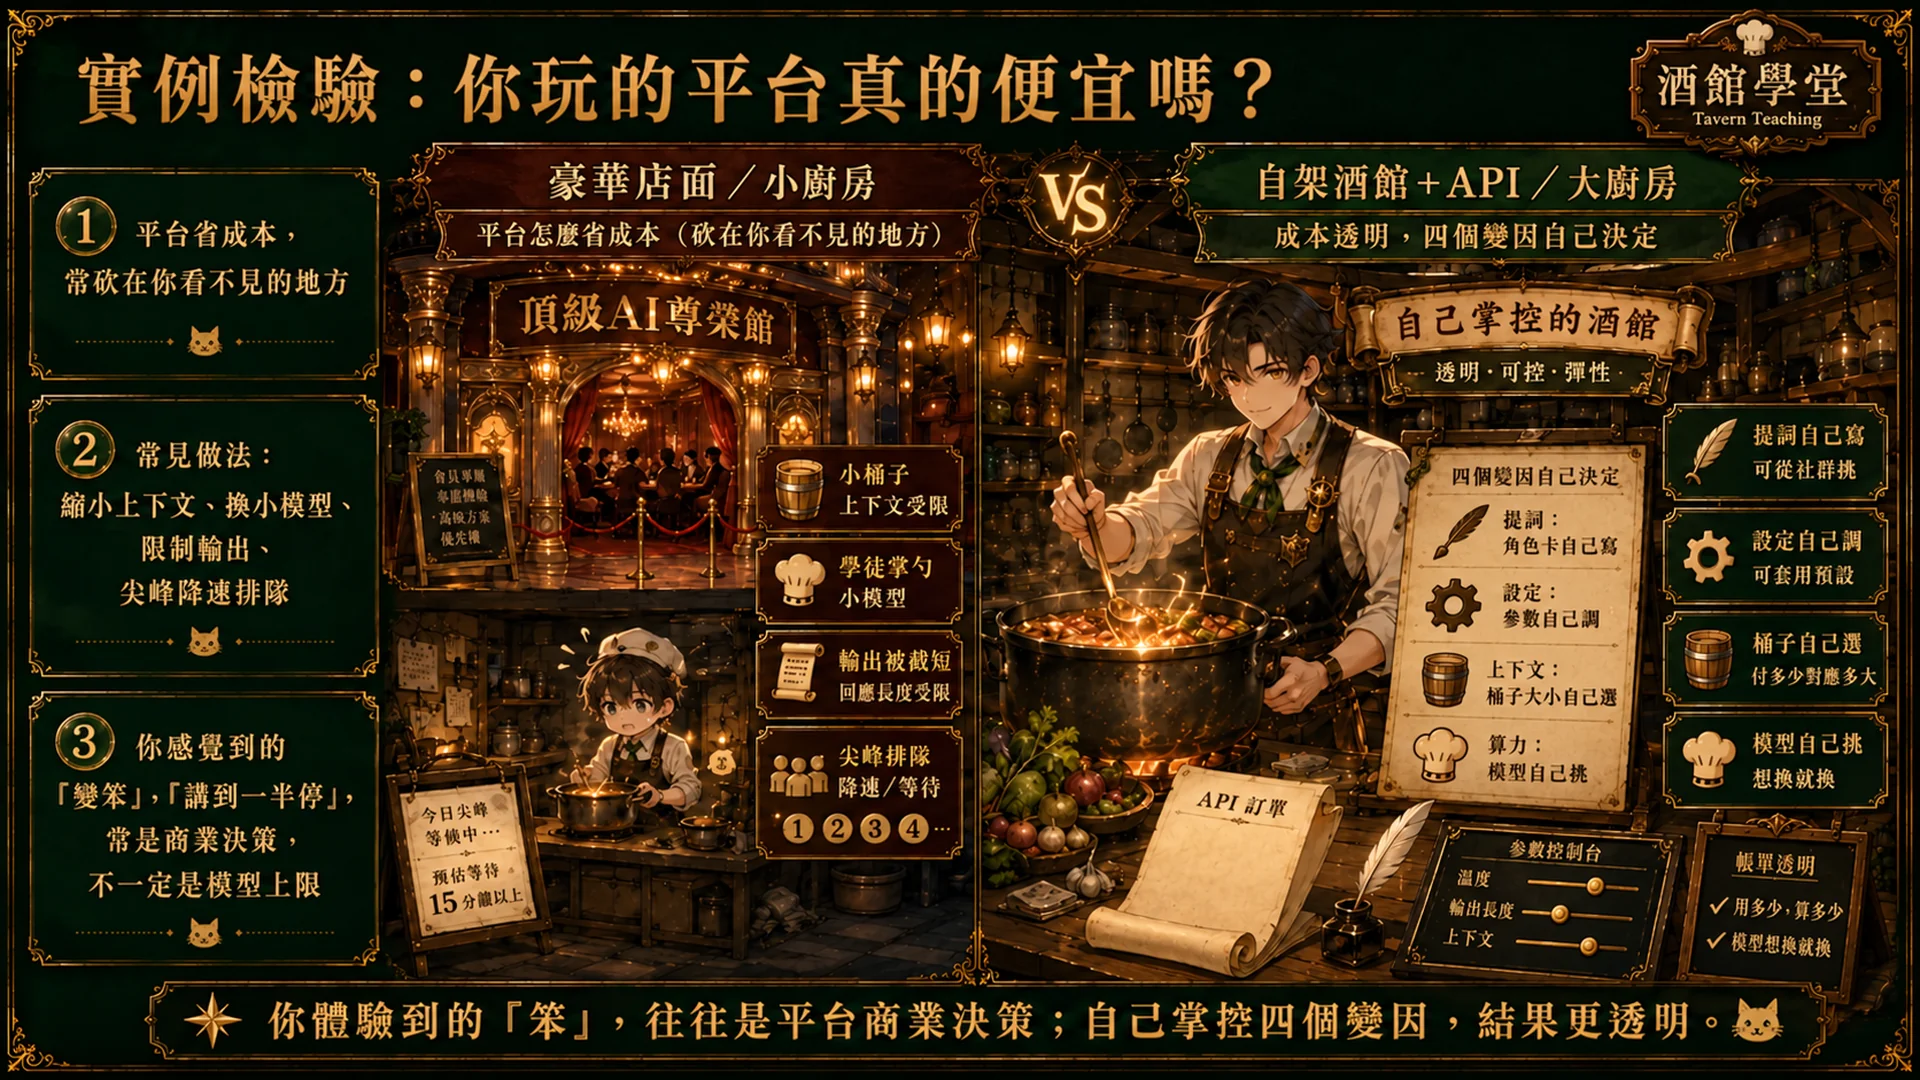
常見的省法 — 全部砍在你看不見的地方:
- 砍上下文長度(桶子變小,失憶更快)
- 換用更小的模型(學徒掌勺代替大廚,算力降低)
- 限制輸出長度(每次回覆被截短)
- 尖峰時段排隊或降速
你體驗到的「這個 AI 好笨」「為什麼老是講到一半就停」,很可能是平台的商業決策造成的,而不是這個模型本身的上限。
對照:自架酒館+自用 API
自己架酒館、自己申請 API,成本完全透明,公式裡的四個品質變因全部由你自己決定:
1提詞:角色卡你自己寫,或從社群挑高品質的。
2設定:參數你自己調,或直接用社群預設。
3上下文:桶子大小你自己選(付多少費用對應多大的桶子)。
4算力:模型你自己挑,想換就換。
自架酒館之後,很多人說「感覺像用了全新的 AI」。其實不是 AI 變了,是這四個變因第一次全在你掌控裡。
常見問題
Q:初學者應該先調哪個設定?
先不要調,用預設就好。最快看到改善的方式是:提升你自己的輸入品質(寫更多細節)、找好的角色卡、裝社群推薦的預設。這三件事的投資報酬率遠高於手動調參數。
Q:Temperature 調高就會變得比較好嗎?
Temperature 控制的是「創意程度」,調高會讓輸出更隨機、更有創意,但也更可能出現胡說八道或跑偏;調低則輸出較保守穩定但容易重複。最好的做法是先用社群推薦的預設(preset),那些預設通常已經幫你調好了一個好的平衡點。
Q:為什麼用那些便宜的平台,AI 有時候回覆超短?
多半是這種方案把輸出長度卡死了。你可以去設定裡找「回應長度」或「最大 Token 數」,看能不能調高;但如果是平台自己設的上限,你怎麼調都沒用。等你自己架酒館、用自己的 API,這個長度才真的是你說了算。
📌 本集重點
- 好回覆 = 提詞 × 設定 × 上下文 × 算力:是乘法不是加法,任何一項是零整體就是零;再乘上你自己輸入的品質。
- 你的輸入是最好改的變因:寫出動作、場景、情緒,大廚就接得更到位;只丟一句「隨便」,他也只能演得保守。
- 免費的代價砍在看不見的地方:砍上下文、換小模型、限輸出、尖峰降速 — 體驗到的「笨」常是省錢決策,不是模型的極限。
下一步
EP6 為什麼酒館是最終點:現在你知道公式的四個變因了,為什麼酒館是唯一能把四個都拿回手上的方法?